XCrawl
XCrawl 是一款专为 AI 代理和自动化工作流设计的网页抓取 API,提供 Scrape、Crawl、SERP、Map 四类接口,输出干净的 JSON/Markdown 数据。内置住宅代理轮换、指纹模拟和 …
 🚀 访问官网 0 📱 手机查看
XCrawl 是什么
XCrawl 是一款面向 AI 代理和自动化工作流的网页抓取与结构化数据 API 服务。它的核心定位很明确:AI 代理的“眼睛”——把网页变成 LLM 能直接消化的干净数据。
传统爬虫开发需要维护 Puppeteer 脚本、代理池、验证码处理和反爬对抗,工程量巨大且容易失效。XCrawl 的解法是把这些全部黑盒化:内置全球住宅代理轮换、浏览器指纹模拟和 30+ 反爬检测模式,开发者只需要发一个 URL,拿回干净的结构化数据。四类 API 各司其职:Scrape 负责单页深度抓取(支持 JS 渲染和无头浏览器),Crawl 负责全站智能爬取(可控制深度),SERP 获取搜索引擎实时结构化结果,Map 自动发现站点全部 URL 生成地图。
XCrawl 最突出的差异化在于AI 原生设计。它提供原生 MCP(Model Context Protocol)服务器,Claude 等 AI 助手可以直接调用 XCrawl 抓取和推理网页数据,不需要额外编写中间层代码。输出格式针对 LLM 优化——Markdown 直接喂给 RAG 管道,JSON 可以直接进入数据库或分析工具,省去了手动解析和正则匹配的环节。
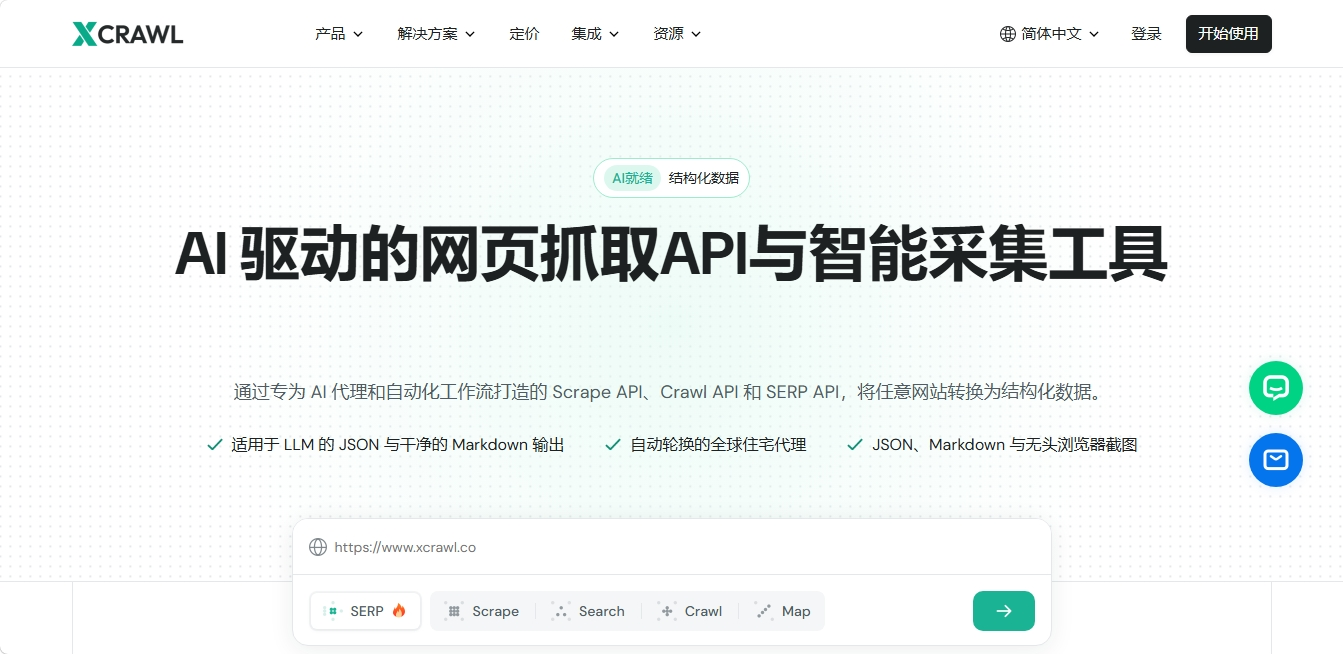
△ XCrawl——给 AI 代理装上实时网络数据的“眼睛”
🔗 官网:xcrawl.ai | 🖥️ 控制台:dash.xcrawl.com
XCrawl 主要功能
🔍 Scrape API——单页深度抓取,输出 Markdown/JSON
支持 JavaScript 动态渲染和无头浏览器加载,直接输出纯净的 Markdown、HTML 或 JSON 结构化数据。基础抓取消耗 1 点数,AI 提取消耗 5 点数——只需在请求中加一个 json 字段和自然语言描述,就能拿到结构化结果,不需要定义 schema。大幅节省 LLM 的 Token 消耗,省去手动解析 HTML 的工作。
🕸️ Crawl API——全站智能爬取,构建 RAG 知识库
针对全站或特定范围进行智能深度爬取,支持自定义爬取深度和 crawler 规则设计。异步结果处理和状态轮询机制适合构建 RAG(检索增强生成)系统和专属知识库。每页消耗 1–5 点数,可以选择出口地区(如 JP、US、DE)。
📊 SERP API——搜索引擎实时结构化结果
程序化获取 Google 等主流搜索引擎的实时结构化结果,2 条结果消耗 2 点数。适合市场监测、SEO 排名追踪和竞品 SERP 分析,省去了手动解析搜索结果页面的麻烦。
🗺️ Map API + 智能反爬——站点发现与穿透防护
自动识别目标站点架构并提取所有页面 URL,快速生成站点地图供后续 Crawl 或分析使用。所有 API 共享内置的反爬能力:全球住宅代理网络自动轮换、浏览器指纹模拟、CAPTCHA 处理,以及对 Cloudflare 等 30+ 反爬模式的自动回退。
🤖 原生 MCP 与 AI 生态集成——Claude 直接调用网页数据
提供原生 MCP 服务器,Claude、Cursor 等 AI 助手可以直接通过 MCP 协议调用 XCrawl 抓取和推理网页数据,不需要自己写中间层。MCP 端点格式为 https://mcp.xcrawl.com/{API_KEY}/mcp,也可以一条命令在 Claude Code 中注册。此外还提供 n8n 节点和 Webhook 异步回调,方便接入自动化工作流。
适合人群
XCrawl 价格方案
1,000 点数一次性 · 无需信用卡 · 全面访问所有 API · 适合验证和原型
5,000 点数/月 · 约 5,000 次基础抓取 · 标准代理 · 轻量级抓取
60,000 点数/月 · 住宅代理 · 更高并发(约 20 并发请求)· 适合中等规模
350,000 点数/月 · 更大规模并发 · 优先技术支持 · 适合批量任务
百万级请求 · 3M 点数/月最高档约 $999/月 · 定制并发和 SLA
基础抓取 1 点 · 搜索(2 条结果)2 点 · AI 提取 5 点 · 全站爬取 1–5 点/页
💡 免费额度是一次性的,不是每月刷新。计费基于信用点(Credits),每次请求根据抓取复杂度和是否使用高级代理扣减不同点数。重度使用者的点数消耗可能不太可预测,建议在正式投入前用免费额度跑真实任务,监控实际消耗速度。Starter 档的并发限制约 20,大规模批量任务需要评估是否升级到 Pro。
✅ 优点
- 反爬工程完全黑盒化:住宅代理轮换、指纹模拟、CAPTCHA 处理和 30+ 反爬模式内置,开发者不需要再维护 Puppeteer 脚本和代理池,这是它最核心的效率价值。
- AI 原生设计,MCP 集成即插即用:原生 MCP 服务器让 Claude 等 AI 助手可以直接调用抓取能力,不需要写中间层。对于正在构建 AI Agent 或 RAG 系统的开发者,集成成本极低。
- 输出直接可用,省去解析环节:Markdown 直接喂 RAG,JSON 直接进数据库,AI 提取用自然语言描述即可,不需要手动写正则或 HTML 解析器。
- 四合一 API 覆盖完整数据链路:Scrape、Crawl、SERP、Map 覆盖单页到全站到搜索到站点发现,不需要为不同任务采购多个工具。入门价格 $8/月也相对友好。
⚠️ 注意事项
- 免费额度是一次性的:1,000 点数用完即止,不是每月刷新。重度使用或大规模爬取会较快消耗完毕,需要提前规划付费方案。
- 点数消耗可能不太可预测:不同任务消耗差异大(基础抓取 1 点 vs AI 提取 5 点 vs 全站爬取 1–5 点/页),高并发或大规模任务的成本可能累积较快,建议密切监控用量。
- 并发限制因套餐而异:Starter 档约 20 并发请求,大规模批量任务可能遇到瓶颈,需要评估是否升级到 Pro 或 Enterprise。
- 公开用户评价样本有限:Capterra 显示 0 条用户评价,aiseekertools 给出 5.0/5 但为编辑评测。实际长期稳定性和不同站点类型的成功率需要用自己的目标网站验证。
📖 使用教程
1
注册并激活免费点数
访问 dash.xcrawl.com 注册账号,无需信用卡。注册后激活免费的 1,000 点数套餐,获取 API Key。这一步大约 30 秒完成。
2
用 Scrape API 跑第一次抓取
向 https://run.xcrawl.com/v1/scrape 发送 POST 请求,传入目标 URL。基础抓取返回干净的 Markdown。如果需要结构化 JSON,在请求中加一个 json 字段并用自然语言描述你要提取的内容即可,不需要定义 schema。
3
接入 Claude / Cursor 的 MCP 服务器
在 Claude Code 中运行 claude mcp add xcrawl -e XCRAWL_API_KEY=YOUR_KEY -- npx -y xcrawl-mcp 注册 MCP 服务器。之后可以直接让 Claude 搜索网页、抓取全文,不需要离开对话界面。
4
扩展到大規模任务前先评估成本
免费点数用完前,用真实目标网站测试 Scrape、Crawl 和 AI 提取的实际点数消耗,评估 Hobby(5,000 点/月)或 Starter(60,000 点/月)是否够用。重点关注并发需求——Starter 约 20 并发,大规模批处理需要 Pro 或 Enterprise。
常见问题
Q:XCrawl 免费吗?
A:免费试用提供 1,000 点数(一次性,无需信用卡),可全面访问所有 API。付费从 Hobby $8/月(5,000 点)起,Starter $49/月(60,000 点),Pro $199/月(350,000 点)。
Q:它和普通爬虫库(如 Puppeteer)有什么区别?
A:XCrawl 把代理轮换、指纹模拟、CAPTCHA 处理和反爬对抗全部黑盒化,你只需要发一个 URL 拿结构化数据。普通爬虫库需要你自己维护这些基础设施,工程量大且容易失效。
Q:MCP 集成怎么用?
A:MCP 端点为 https://mcp.xcrawl.com/{API_KEY}/mcp。在 Claude Desktop 中添加到配置文件,或在 Claude Code 中运行 claude mcp add 命令即可。注册后 Claude 就能直接调用 XCrawl 抓取网页数据。
Q:点数怎么消耗的?
A:基础抓取 1 点,搜索(2 条结果)2 点,AI 提取 5 点,全站爬取 1–5 点/页。使用住宅代理或高复杂度任务可能消耗更多。免费 1,000 点是一次性的,不是每月刷新。
Q:支持哪些编程语言?
A:提供 Python、Node.js/TypeScript 和 Go 的官方 SDK,同时兼容 REST API,任意语言都可以调用。还提供 n8n 节点和 Webhook 用于无代码自动化。
相关工具推荐
选择建议:XCrawl 的核心优势在于反爬黑盒化 + 原生 MCP 集成 + 四合一 API 覆盖完整数据链路。如果你正在构建 AI Agent 或 RAG 管道,需要一个“发 URL 拿干净数据”的基础设施,且希望 Claude 等助手能直接调用网络能力,XCrawl 是当前集成路径最短的选择之一。Firecrawl 是功能最接近的竞品,Apify 适合需要更复杂自动化编排的场景,Browserbase 则与 XCrawl 互补而非替代。
✍️ NavCN 点评
XCrawl 做的是 AI 时代数据基础设施里最脏最累但最刚需的那一层:把网页从“给人看的 HTML”变成“给 LLM 吃的干净数据”,并且把代理轮换、指纹模拟、验证码这些反爬脏活全部黑盒化。它的产品定位非常清醒——不试图做全功能爬虫平台,而是做一个单次 API 调用就能出结构化结果的“数据管道入口”。原生 MCP 集成是它最聪明的设计:Claude 等 AI 助手可以直接调用抓取能力,开发者不需要写任何中间层,这在 AI Agent 开发节奏越来越快的当下,集成成本的优势会被放大。四类 API(Scrape/Crawl/SERP/Map)覆盖了从单页到全站到搜索到站点发现的完整链路,$8/月的 Hobby 门槛也足够低。需要留意的点:免费 1,000 点是一次性的不是每月刷新,点数消耗会随任务复杂度波动,Starter 档约 20 并发对大规模批处理可能不够。Capterra 上暂时没有用户评价,长期稳定性还需要更多真实场景验证。如果你正在给 AI 应用或 Agent 找一个可靠的“联网获取数据”层,XCrawl 值得用免费点数在你的目标网站上跑一轮真实测试。