第一次在Midjourney里生成图片,我打了一句"a cat",出来四张模糊的橘猫,背景全是噪点。我以为AI就这水平,后来才知道,问题出在我自己身上。
这篇不扯注册和订阅,只讲一件事:怎么在Midjourney里生成一张能看的图。
先确认两件事
在Discord里输入/info,看到"Active"和套餐名字,才算生效。没生效的话,发指令Bot不会理你。
别在官方公共频道里画。消息刷得太快,你的图几秒钟就被淹了。建一个自己的私人服务器,把Midjourney Bot拉进去,所有图都留在自己地盘上。
这两件事确认完,就可以开始了。
核心命令就一个:/imagine
在输入框里打/imagine,菜单会弹出来。选中之后,输入框变成prompt:开头,后面跟你的描述。
Midjourney只认英文。你打中文它也能收到,但出来的图基本是随机的。所以先把中文想法翻成英文,再丢进去。
我刚开始犯的错,是像以前用其他AI那样堆关键词:cat, cute, fluffy, 8k, masterpiece。这种写法在V6之前可能还行,现在出来的东西又乱又假。
现在的Midjourney更吃"完整的句子"。你像跟人说话一样描述,它反而理解得更准。对比一下:
第二种出来的人、景、光、感觉都对。因为它有逻辑,不是一堆词硬凑。
金毛幼犬是主体,木地板是场景,窗边晨光是光线,极简摄影是风格。四句话,很清楚。
回车之后,等一分钟
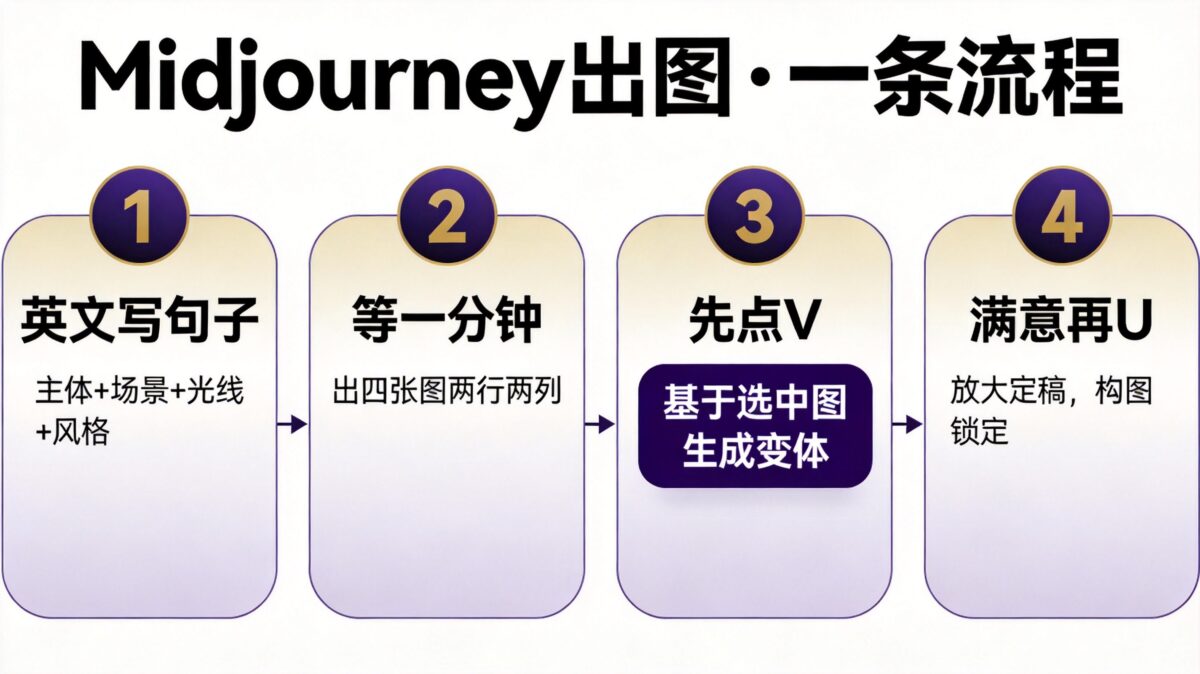
发送之后,Bot会先显示"Waiting to start",然后开始生成。大概一分钟左右,出来四张图,排成两行两列。
四张图下面有两排按钮,新手最容易搞混:
放大对应位置的图。U1左上、U2右上、U3左下、U4右下。
基于对应位置的图,再生成四张变体。
按当前提示词,重新生成四张全新的图。
我的习惯是:先点V,别点U。U是"定稿"操作,一旦放大,这张图的构图和风格就固定了,方向不对得从头再来;V是"微调",比如第三张方向最对,点V3,它基于第三张生成四张变体,你继续挑、继续V,直到满意了再U。
参数:常用的就那几个
参数加在提示词末尾,用两个短横线开头。
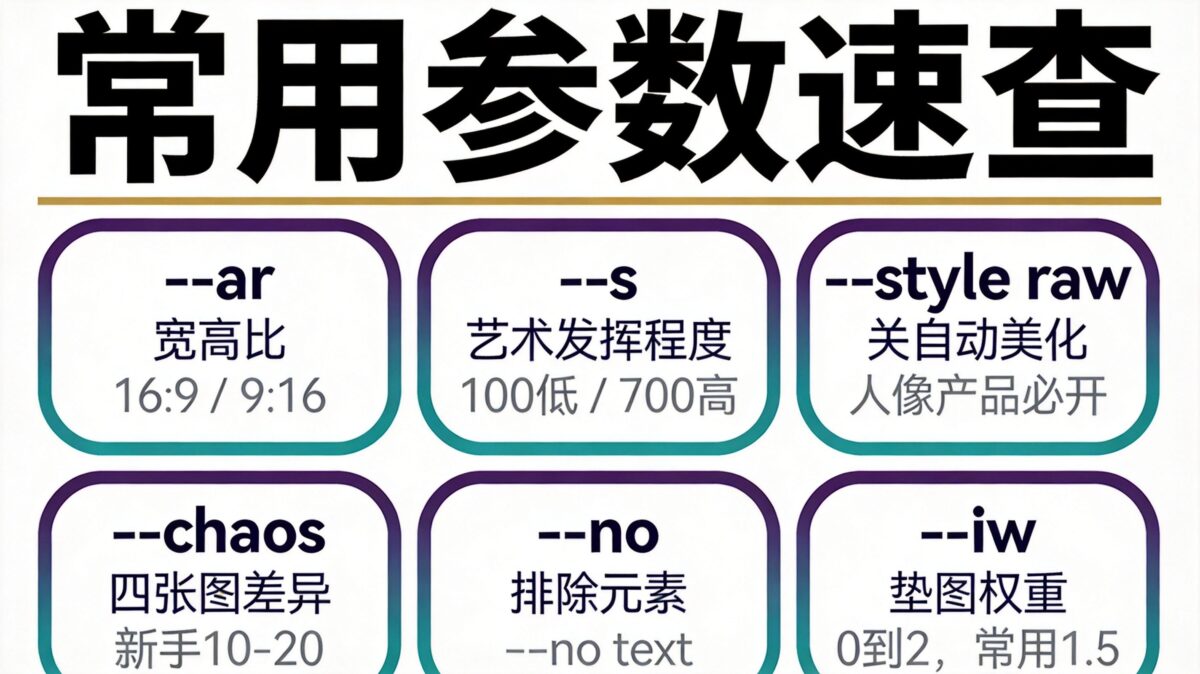
默认1:1。手机壁纸用--ar 9:16,视频封面用--ar 16:9,小红书封面用--ar 3:4。
默认100,数值越低越贴近你写的字面意思,越高越会自己加艺术效果。我一般用250到500,想老实就100,想创意就700。
做人像和产品图时必开。不开的话,人脸容易有塑料感,产品图容易失真。
控制四张图的差异。默认0,四张比较接近;调到20-30有明显不同方向;调到100可能完全不相关。新手10-20就够。
不想图里有文字,加--no text, watermark;不想有人,加--no people。
先用这套跑草图,定稿时再加--q 2提升质量,但会多花点GPU时间。
垫图:让AI照着参考画
光靠文字说不清楚,想让AI照着某张图的感觉画,这就是垫图。
- 先把参考图上传到Discord:输入框点"+"号,选图片,发送。
- 图片发出后,右键点击图片 → 复制图片地址。
- 输入框里打:
/imagine prompt: [粘贴图片地址] 你的描述 --iw 1.5
--iw是图片权重,范围0到2,数值越高越贴近参考图。默认1,我一般用1.5左右。
进阶:局部重绘和扩图
放大后的图点这个按钮,用画笔涂出要改的区域,写新描述,只改那一块。比如脸不对,涂掉写"a smiling face"。
把画面往外扩,在原图周围生成新内容,画面变大,适合做壁纸或需要更多留白。
往上下左右扩,点箭头按钮,它往那个方向扩展画面。
Describe上传图反推四组英文提示词,方便模仿;Blend上传2-5张图融合成一张新的。
新手最容易踩的坑
/info看剩余Fast时间,Basic档3.3小时很快没了,用完可切Relax(Standard以上)。最后说一句
Midjourney生成图片这件事,前几次是最难的。提示词、参数、按钮、额度,每个概念都是新的,叠在一起容易想放弃。
但过了那个阶段,你会发现它其实就是一件事:把你想的画面,用英文说清楚,然后等一分钟。不满意就改一个词,再跑一版。这个过程本身挺有意思——你永远不知道下一版会出来什么。
打开Discord,输入/imagine,从第一句简单的英文描述开始。
本文基于2026年10月最新版本实测,各功能和参数可能随时调整,请以官方最新信息为准。
