
用 AI 做视频,最难的从来不是"生成"。打开工具,输入一句话,等一分钟,你就能得到一段画面。难的是生成之后你发现,这些画面单独看都挺好看,拼在一起却不像一条片子——不知道它在讲什么,也不知道为什么要看下去。
这篇教程不按"工具推荐"的路子写,而是拿一个具体的需求,从头到尾走一遍。你跟着做,能做出第一条属于自己的片子。做完之后,再换工具、换题材,流程是一样的。
需求很简单:给一家街角咖啡店做一条 30 秒的探店短视频,发在抖音和小红书上。
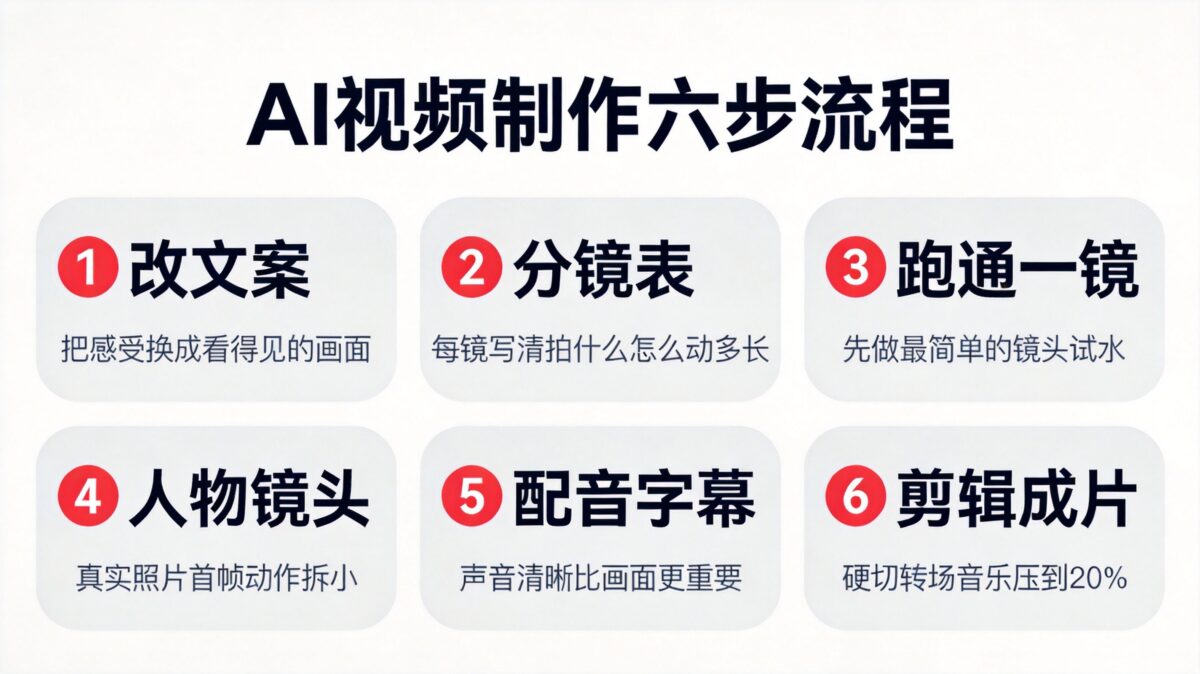
第一步:先把文案改成"能拍的"
大多数人做 AI 视频的第一步是错的——打开工具,想一句提示词,生成,看效果。这个顺序会让你在"画面好看但没意义"的素材里打转。
正确的第一步是:把你想说的话,改成"看得见"的话。
假设你手头有这样一段文案:
"这家藏在巷子里的咖啡店,环境特别舒服,咖啡也很好喝,老板人很好,推荐大家来坐坐。"
这段话拿去生成,模型会给你一个咖啡店。哪个咖啡店?不知道。"特别舒服"是什么画面?"人很好"怎么拍?模型没法回答。
你需要把"判断"换成"画面",把"感受"换成"动作"。改完之后大概是这样的:
"巷子尽头,推开门,风铃响了一声。靠窗的位置,阳光落在木桌上。老板端来一杯拿铁,拉花是一颗歪掉的心。他说,今天豆子烘得有点深,你先尝尝。"
现在每一句都有画面了。风铃、阳光、木桌、歪掉的拉花、老板说话的动作。模型知道该拍什么,观众也知道该看什么。
这一步不需要任何工具。在备忘录里一句一句改,改到每一句都能在脑子里"看见"为止。改好了再往下走。
第二步:写一张"能执行"的分镜表
文案改完,下一步是把它拆成镜头。
分镜表不用很正式,在手机备忘录里列几行就行。但每一行至少要写清楚四件事:这一镜拍什么、镜头怎么动、大概多长、配什么声音。上面那段文案,拆出来大概是这样的:
| 镜头 | 画面 | 运镜 | 时长 | 声音 |
|---|---|---|---|---|
| 1 | 巷子全景 | 缓慢向前推 | 3秒 | 环境音:巷子里的脚步声 |
| 2 | 手推开门 | 特写 | 2秒 | 音效:风铃响 |
| 3 | 靠窗的木桌,阳光落在桌面上 | 固定机位 | 3秒 | 旁白:"靠窗的位置,阳光刚好。" |
| 4 | 老板端来拿铁 | 中景,跟拍 | 3秒 | 旁白:"老板端来一杯拿铁。" |
| 5 | 拉花特写 | 轻微推近 | 3秒 | 旁白:"拉花是一颗歪掉的心。" |
| 6 | 老板说话 | 中近景,固定机位 | 4秒 | 同期声:"今天豆子烘得有点深,你先尝尝。" |
| 7 | 顾客端起杯子喝一口,微笑 | 中景 | 3秒 | 无旁白,音乐渐起 |
| 8 | 店门口全景 | 缓慢后退 | 3秒 | 旁白:"巷子尽头,下次见。" |
八个镜头,不到 30 秒。每一镜只有一个动作、一种运镜。拍不出来的心理活动,交给旁白和画面之间的配合。
分镜表写完,你才算真正知道"要做什么"。后面生成、配音、剪辑,都是照着这张表执行。
第三步:选一个工具,先跑通一个镜头
工具不用选太多。2026 年主流的 AI 视频工具,能力差距没有你想象的大。可灵、Seedance(即梦)、Runway、MiniMax H3,随便选一个都能跑通。
新手建议从可灵或者即梦开始。中文界面,免费额度够练手,提示词用中文写就行。
不要一上来就生成八个镜头。先拿镜头 3 试水——画面简单,只有一张桌子和阳光,没有人物动作,成功率最高。
提示词按这个结构写:
镜头 3 写出来大概是这样:
一张靠窗的木质咖啡桌,桌面上有阳光的光斑,窗外是模糊的绿植,下午的暖色侧光,固定机位,中景,电影质感,画面中不要出现文字、Logo 和水印。
生成之后,先看三件事:桌子有没有变形,光斑的位置自不自然,窗外是不是绿植而不是别的什么东西。这三件事没问题,再继续下一镜。
第一版不要追求"好看",追求"不崩"。基线稳了,后面才有调的空间。
第四步:有人物的镜头,单独处理
八个镜头里,镜头 4、5、6、7 都有人。人物是 AI 视频里最容易翻车的部分——脸变、手崩、动作僵。处理人物镜头,有几个实用的办法。
如果你有老板端咖啡的照片,把它作为首帧上传,让模型在这个基础上"动起来",比纯文字生成稳定得多。可灵和即梦都支持图生视频。
不要写"老板端着咖啡走过来微笑打招呼",拆成"老板端着咖啡走过来"和"老板微笑说话"两个镜头分开生成。一个镜头一个动作,模型不容易崩。
需要露脸的镜头,尽量用正脸或小角度侧脸作为首帧。侧脸和大角度回头,模型需要"猜"骨骼结构,猜错的概率高很多。
生成完放大看手。端杯子的手、开门的手,是最容易出问题的地方。有问题用局部重绘修,或者换一个不露手的构图重新生成。
人物镜头跑完之后,完整看一遍。不要只看前三秒,问题往往出现在中段——脸开始漂、手开始变形、动作突然卡住。
第五步:配音和字幕,别让声音拖后腿
画面齐了,下一步是声音。观众对声音的容忍度比画面低得多。画面糊一点,人能看下去;声音糊了、节奏不对、字幕对不上,人马上就关了。
旁白自己录最自然。手机自带的录音机就够,找个安静的房间,离麦克风一拳距离,语速比平时慢一点。录完不用做复杂处理,剪映的"降噪"和"音量均衡"够用。
如果不想自己录,剪映内置的朗读音色已经能用了。选一个不太"播音腔"的,语速调到 0.9 到 1.0 之间。即梦和可灵也内置了配音,生成完画面可以直接加旁白。
同期声建议保留原声。AI 生成的同期声口型对不上是常态,与其硬配,不如用画外音的方式处理——画面拍老板说话的动作,声音用旁白转述。
字幕用剪映的"识别字幕"生成,然后手动过一遍,改掉识别错的店名、人名、数字。字幕样式白字加黑色描边,字号别太小,手机上能看清就行。
第六步:剪辑,把素材拼成片子
最后一步在剪映里完成。按分镜表的顺序排列片段,对好旁白和画面的时间点。几个具体的建议。
- 转场用硬切,不要加花哨的效果。AI 生成的片段之间,硬切比转场更自然。需要过渡的地方,用简单的淡入淡出就够。
- 背景音乐压到 20% 到 30%。旁白出现的时候,音乐不能抢戏。人声清晰了,片子就专业了一半。
- 画幅一开始就定好。抖音和小红书都是竖屏,9:16。不要生成完了再裁,构图逻辑不一样,事后裁剪等于把有效画面砍掉一块。
- 导出前完整看一遍。重点看中段:人物有没有突然走样,字幕和旁白有没有对不上,音乐有没有在某处突然断掉。看完再导出。
几个新手一定会踩的坑
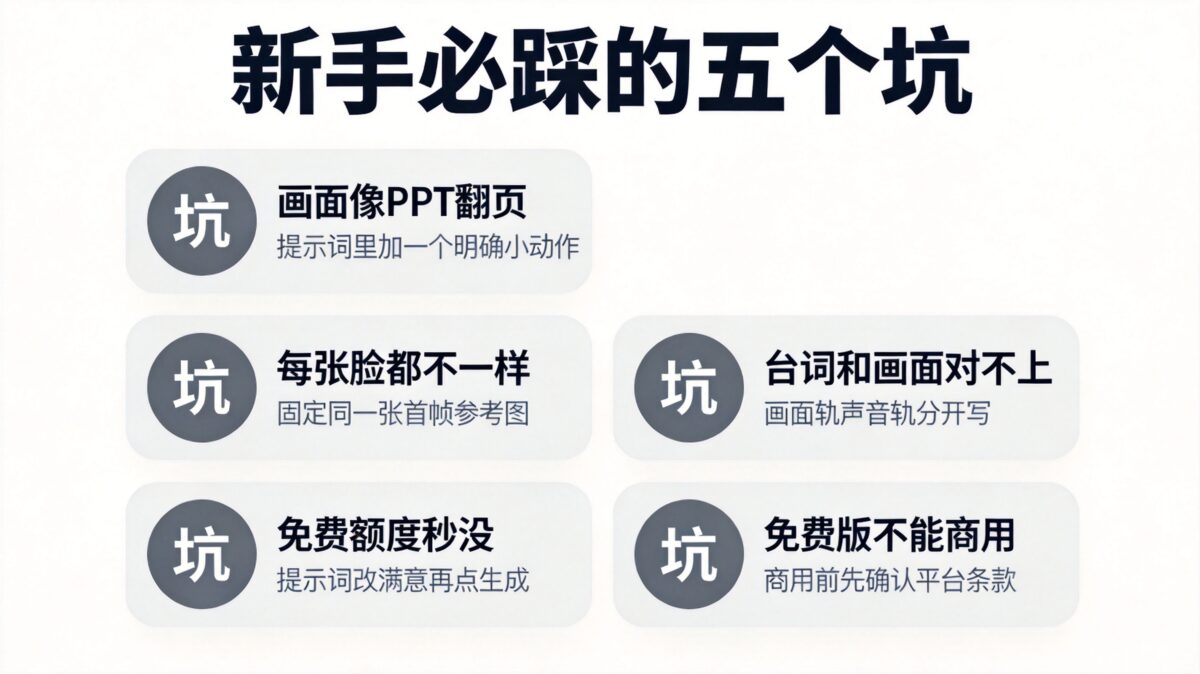
动作太小,或者提示词里只有场景没有动作。加一个明确的小动作,哪怕只是"转头"或"伸手",画面就会活起来。
这是 AI 视频最顽固的问题。分段生成时尽量用同一张参考图作为首帧,或者用可灵的主体引用功能锁定人物。完全一致目前做不到,但能控制在"看起来是同一个人"的程度。
旁白和画面分两轨写。画面轨只写"看得见的东西",声音轨只写"听得见的东西"。不要在画面提示词里写"他说咖啡很好喝",那是声音的信息。
把试错放在草稿阶段。提示词在备忘录里改好,确认没问题再点生成。可灵免费档每天大约 66 积分,实际每天能生成一次图生视频。不要用正式生成的额度去"试感觉"。
大部分免费档明确不可商用。可灵和 Pika 的免费套餐都有这个限制。如果片子要用于商业项目,生成前先确认平台条款。
从文案到视频,真正花时间的不是"生成",是前面两步:把文案改成能拍的样子,把能拍的样子拆成分镜。
这两步做了,生成只是填空,剪辑只是拼接。这两步省了,生成出来的东西再好看,也只是素材,不是片子。
打开你的备忘录,把你想拍的那段话,改写成三个"看得见"的镜头。这就是第一步。